Visual AI · 2026原型
Poster Vision AI
Poster Vision AI: print visual QA
文宣視覺檢測中心
Visual AI · 2026
Poster Vision AI
文宣視覺檢測中心
熱圖是像素/AI 推估,不是眼動儀
上傳或使用樣本海報。面積、對比、文字帶是本機像素運算。 熱圖與區域是像素對比推估,不是眼動追蹤。
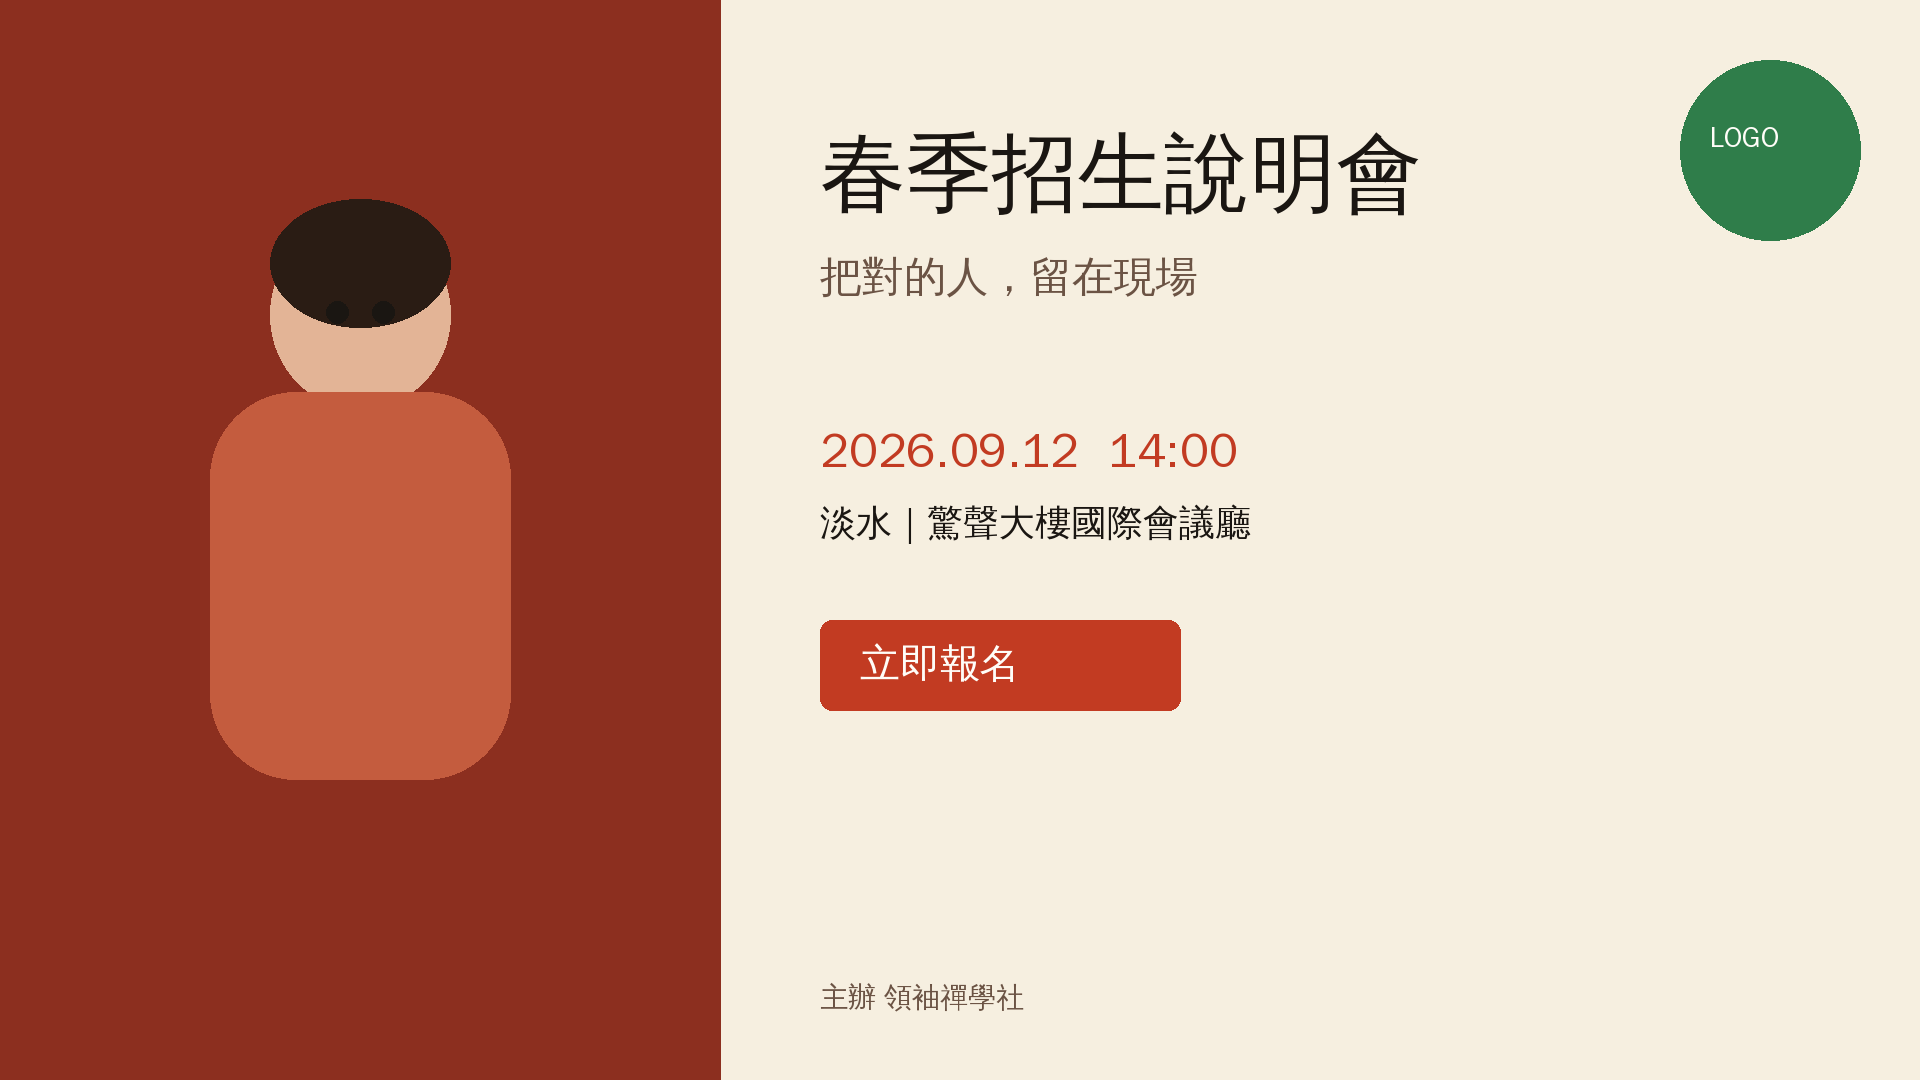
像素推估 · 非眼動儀
樣本載入後會自動畫熱圖。也可再按分析。計算有解析度上限,細節會被縮小。
一句話
上傳海報後,用真實像素運算加上可選的 Grok Vision,推估人物與標題比重,並給帶數字的修改建議。視線與熱圖一律標示為 AI 推估。
來源與證據
GitHub README · poster-vision-ai
功能與限制原文來自 README。
https://github.com/aa0968111723-prog/poster-vision-aiGitHub 公開畫面 · poster-vision-ai
本站 /media/github-exports/poster-vision-ai 複製自公開 repo public/samples。是分析用 fixture,不是 Canva 原作或 Drive 私有檔。
https://github.com/aa0968111723-prog/poster-vision-ai
GitHub verified · Demo not_configured · Canva not_configured
問題
社團與活動文宣常常「自己覺得很大」,印出來或縮成 IG 縮圖才發現主標看不見。需要可執行的修改建議,而不是空泛美學評語。
我的角色
視覺 AI 產品設計:檢測流程、目的計分、前後比較與回饋紀錄。
設計決策
- 面積、顯著性、對比、構圖用像素運算;語意/OCR 才走視覺模型。
- 熱圖與第一眼標記明確寫成推估,不是眼動儀。
- 分數當次計算,模型失敗寫入 degraded[],不假裝成功。
- 預設不永久保存原圖。
AI 使用方式 / 多模態
- 圖像
- 熱圖
- OCR
- 修改建議
流程
- 上傳海報並選擇文宣目的
- 幾何引擎偵測元素與文字區
- 可選語意標籤
- 輸出問題與建議
- 修改前後比較與回饋
產出
- 分析 JSON:元素、面積比、可讀性、手機縮圖指標
- REST API 供後續系統接入
技術
- TanStack Start
- Python OpenCV
- YuNet
- Grok Vision
- SQLite
限制與尚未完成
- 熱圖不是真實眼動追蹤。
- 第一版回饋只存資料庫,尚未自我訓練。
- 沒有 API key 時 OCR 降級為文字區域框。
- Vercel 若無 Python 會改用 JS 顯著性引擎。